在 Google Search Console(GSC)的「网页索引编制」报告中,「备用网页(有适当的规范标记)」很容易被当成无需处理的提示。我的站点遇到它时,网址检查的结果是这样的:
- 用户声明的规范网址:
https://zengliangyi.com/en/blog/tag/tailwind-css/ - Google 选择的规范网址:与用户声明的相同
- 引荐来源网页:
https://zengliangyi.com/en/blog/tag/tailwind-css/
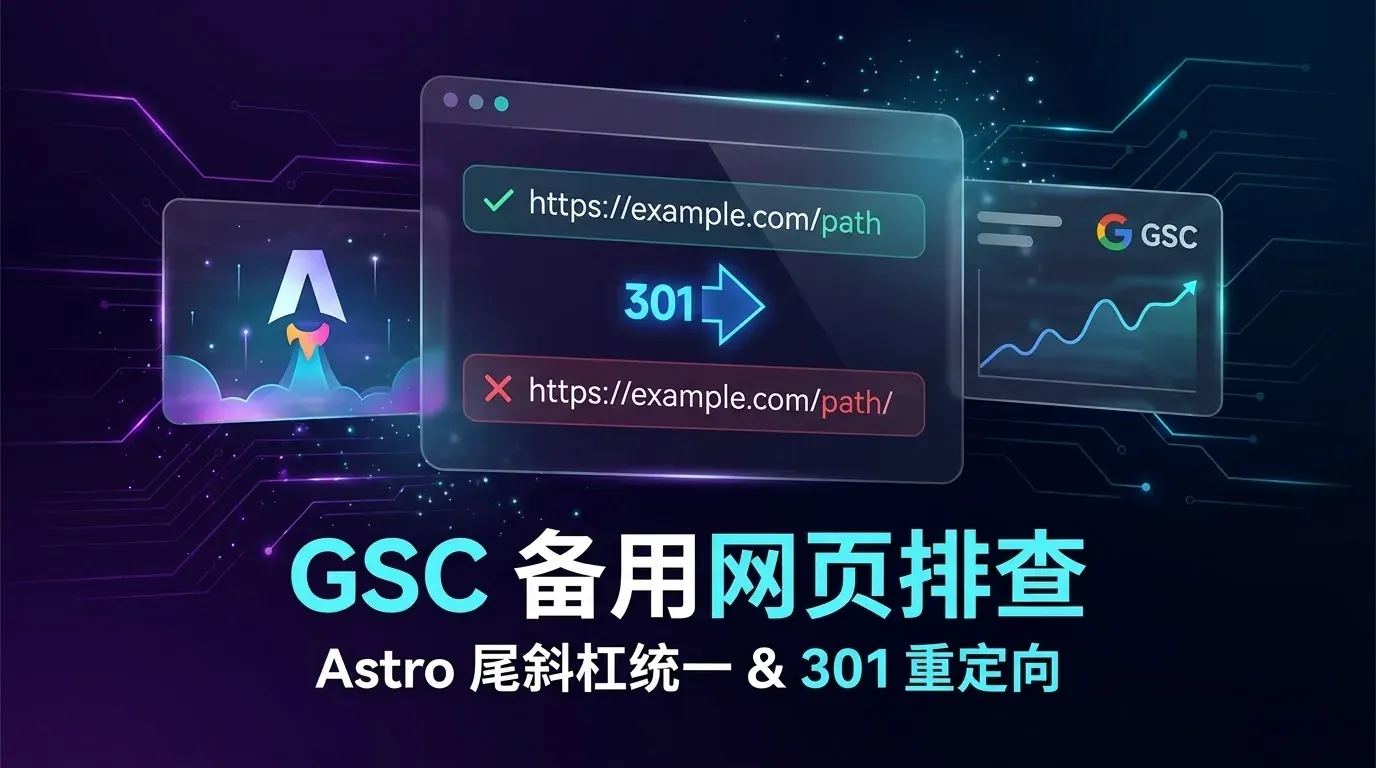
规范网址和引荐页看起来是同一个地址,那么被判为「备用」的是哪一个?被检查的其实是不带尾斜杠的 /en/blog/tag/tailwind-css。Google 抓取它后读到 canonical 指向带斜杠的版本,就把它归为备用网页。引荐来源一栏说明了更关键的事实:这个不带斜杠的地址,是 Google 在我自己站内的页面上发现的。
💡 如何在 GSC 查看引荐来源? 点击报告列表中的 URL -> 点击「检查网址」-> 展开**「发现」卡片 -> 查看「引荐来源网页」**。这能直接确认 Googlebot 是从哪个页面顺着内链爬到这个地址的。
「备用网页(有适当的规范标记)」是什么意思
这个状态说明三件事:
- Google 抓到了一个网址 A;
- A 的 canonical 指向另一个网址 B;
- Google 同意这个判断,把 B 编入索引,A 不展示。
从索引结果看,canonical 已经生效,B 正常收录。问题出在 A 的数量和来源。如果 A 是外部网站偶尔链接的旧地址,影响很小;如果 A 来自站内每个页面的导航和面包屑,Google 每抓一批页面就会发现一批 A,抓取预算被重复地址分走,GSC 报告中的备用网页也会持续增加。
根因:canonical 带斜杠,站内链接不带
这个站点基于 Astro,部署在 Cloudflare Workers。排查后发现各处的网址写法并不一致:
| 位置 | 写法 |
|---|---|
| 构建产物 | /blog/tag/css/index.html(Astro 默认 build.format: 'directory') |
<link rel="canonical"> |
带斜杠 |
sitemap-0.xml |
带斜杠 |
页面中的 <a href>(导航、标签、分页等) |
不带斜杠,如 /en/blog/tag/tailwind-css |
BreadcrumbList JSON-LD 的 item |
不带斜杠 |
BlogPosting 作者主页 URL、llms.txt |
不带斜杠 |
Astro 的 trailingSlash 默认为 'ignore',路由层面两种写法都能访问到同一页面,开发时不会报任何错误。组件里通过 localizedPath('/about', locale) 一类的辅助函数拼路径,返回的都是不带斜杠的形式。站点地图和 canonical 由 Astro 根据产物生成,自然带斜杠。两套写法各自正确,合在一起就形成了「声明一个地址,链接另一个地址」。
构建后统计,全站 HTML 中有 14,172 个指向站内页面的链接缺少尾斜杠。
选择带斜杠还是不带斜杠
Google 官方没有偏好,要求只是统一。这里选带斜杠,理由来自产物结构:
- Astro 目录构建输出
/slug/index.html,带斜杠的地址与文件位置一一对应; - canonical、站点地图已经是带斜杠的,改动只需收敛到链接这一侧;
- 已被收录的规范网址不变,不需要让 Google 重新选择 canonical。
如果反过来改成不带斜杠,需要同时改 build.format、canonical、站点地图和已收录网址,风险更高。
为什么只加 301 不够
最直接的想法是在边缘层把不带斜杠的请求 301 到带斜杠的地址。这能让 Google 合并信号,但站内链接不改的话:
- 爬虫每次跟随站内链接,都先请求旧地址再跟随跳转,抓取次数翻倍;
- GSC 中「备用网页」会变成大量「网页会自动重定向」,问题换了个名字仍在报告里;
- 每个页面多一次跳转,用户点击站内链接也多一次往返。
所以顺序是:先让站内链接直接指向规范网址,301 只负责外部旧链接和历史抓取记录。
修复:从链接源头统一到构建期校验
1. 统一的路径函数
新增 src/lib/canonical-path.ts,只对站内页面路径补斜杠,跳过静态文件、API 和外部链接,并保留查询参数与锚点:
const FILE_EXTENSION_RE =
  /\.(?:xml|json|txt|md|html|htm|png|jpe?g|webp|gif|svg|ico|webmanifest|woff2?|ttf|otf|eot|css|js|mjs|cjs|map|pdf|zip|wasm)$/i;

const NON_PAGE_PREFIX_RE = /^\/(?:api|\.well-known|_astro|images|assets)(?:\/|$)/;

export function ensureTrailingSlash(href: string): string {
  if (!href || !href.startsWith('/') || href.startsWith('//')) return href;
  // 拆出 #hash 与 ?query,只对 pathname 判断
  // '/about#faq' -> '/about/#faq','/rss.xml' 保持不变
  // ...
}
/.well-known/api-catalog 这类没有扩展名、但不是页面的路径,通过前缀白名单排除,避免误补斜杠后返回 404。
2. 结构化数据与文本索引
面包屑组件同时输出可见链接和 BreadcrumbList JSON-LD,两处都经过 ensureTrailingSlash:
const schemaItems = items.map((item) => ({
  name: item.label,
  url: new URL(ensureTrailingSlash(item.href ?? Astro.url.pathname), siteConfig.url).toString(),
}));
BlogPosting 中的作者主页 URL 和 llms.txt 里的文章、项目地址也做了同样处理。结构化数据里的 URL 同样会被搜索引擎当作网址发现来源,只改 <a href> 不够。
3. 构建后统一重写 HTML 链接
导航、标签云、分页等组件分散在几十个文件里,逐个改容易遗漏。站点已有一个在 astro:build:done 阶段遍历全部 HTML 的集成(用于生成给 AI Agent 的 Markdown 版本),就在这里统一重写 <a href>:
for (const htmlPath of htmlFiles) {
  const rawHtml = await readFile(htmlPath, 'utf8');
  const htmlContent = normalizeInternalPageHrefs(rawHtml);
  if (htmlContent !== rawHtml) {
    await writeFile(htmlPath, htmlContent, 'utf8');
  }
  // 随后基于规范化后的 HTML 生成 Markdown
}
这样后续新增的组件即使手写了不带斜杠的链接,产物中也会被修正,Markdown 版本中的链接也保持一致。
4. Cloudflare Worker 中的 301 兜底
wrangler.toml 中设置了 run_worker_first = true,所有请求先经过 Worker 入口。301 直接写在入口函数中,不依赖 Cloudflare 控制台的重定向规则,规则和代码一起版本管理:
if (
  (request.method === 'GET' || request.method === 'HEAD') &&
  url.pathname !== '/' &&
  !url.pathname.endsWith('/') &&
  !FILE_EXTENSION_RE.test(url.pathname) &&
  !NON_PAGE_PREFIX_RE.test(url.pathname)
) {
  return Response.redirect(url.origin + url.pathname + '/' + url.search, 301);
}
部署后验证:
$ curl -sI https://zengliangyi.com/blog
HTTP/2 301
location: https://zengliangyi.com/blog/
5. 构建期校验,防止回退
只修一次不够,以后新增组件仍可能写出不带斜杠的链接。scripts/verify-build.mjs 新增两项检查,有任何一条不合规就让构建失败:
- 所有
BreadcrumbList的item必须以/结尾; - 所有 HTML 中的站内页面
<a href>必须以/结尾。
按仓库约定,这个检查先在修复前的产物上运行,确认它会报错:它报出了缺少尾斜杠的面包屑条目和 14,172 个站内链接。修复后重新构建,检查通过。只在正常产物上跑过的检查,无法证明它能发现问题。
修复后 GSC 会怎样变化
- 新页面:站内不再出现不带斜杠的链接,Google 不会再从站内发现重复地址;
- 已记录的旧地址:Google 重新抓取时得到 301,状态从「备用网页」转为「网页会自动重定向」,这是预期结果;
- 看报表时,在「网页索引编制」中把筛选从「所有已知网页」切换为「所有已提交的网页」,只看站点地图里的规范网址。这里不应出现重定向或备用网页。
另外,http://、www. 跳转到 https:// 主域名后出现在「网页会自动重定向」里,也是同一类正常结果,不需要处理。
小结
「备用网页(有适当的规范标记)」说明 canonical 在工作,但也说明站点在向 Google 提供重复网址。处理顺序是:
- 根据产物结构选定一种网址写法;
- 让站内链接、结构化数据、文本索引直接使用规范网址;
- 在边缘层用 301 兜底外部旧链接;
- 在构建期校验,防止以后回退。
修复后可以配合主动推送让搜索引擎尽快重新抓取,增量推送的做法见《Astro 静态站点接入 Google Indexing API:增量推送与缓存》;同类的构建产物落盘校验思路也用于拦截 Astro + Cloudflare 编译期 WebP 转换下的 og:image 404 陷阱。